Claude, GPT o Gemini: Qué modelo de IA elegir en 2026
Descubra qué modelo de IA (Claude, GPT o Gemini) elegir para la automatización empresarial a medida en 2026 según costos, gobernanza y rendimiento.
- Claude GPT o Gemini
- Qual Modelo de IA
- Sob Medida em 2026
- Automatización de Procesos
- Agentes de IA
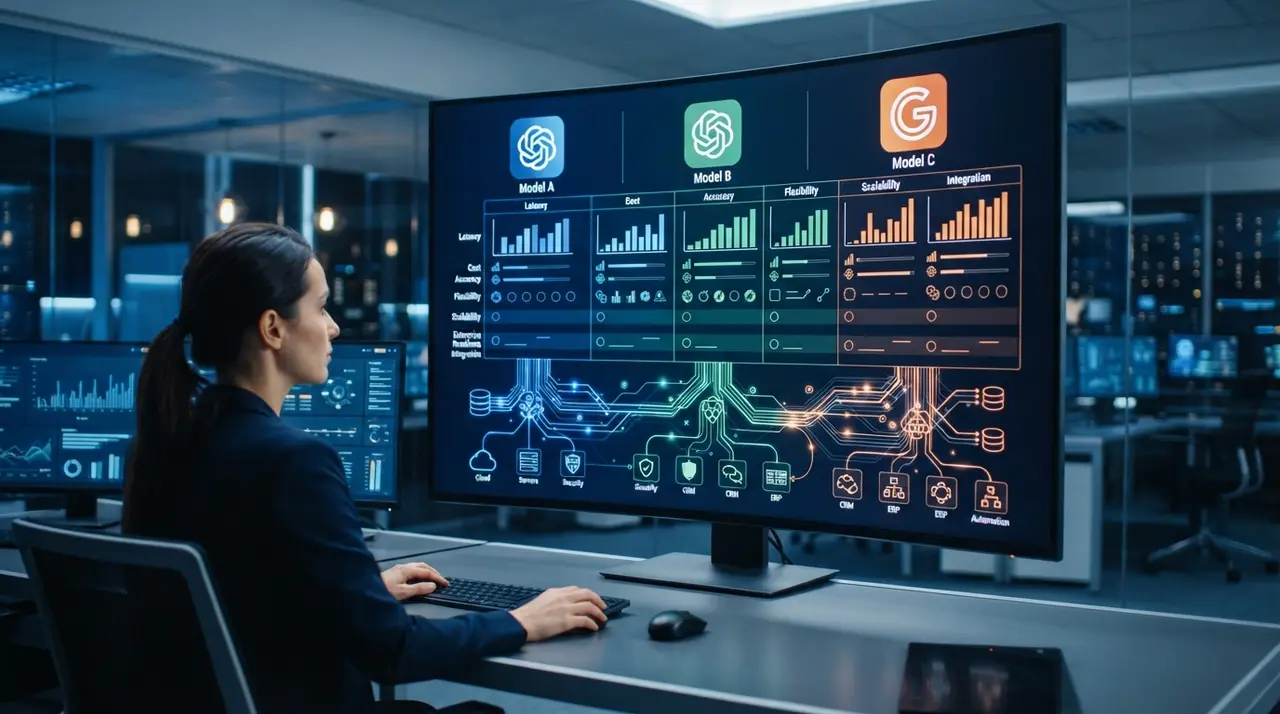
Elegir entre Claude, GPT o Gemini para desarrollar una automatización empresarial a medida en 2026 requiere evaluar la precisión operativa, el costo por token y la gobernanza de datos de cada opción. No existe un modelo único superior para todos los procesos corporativos; las organizaciones líderes adoptan arquitecturas agnósticas que combinan diferentes motores de Inteligencia Artificial según la tarea concreta.
Muchas empresas comienzan su viaje probando interfaces de chat comerciales. Sin embargo, cuando el objetivo es integrar agentes inteligentes en el CRM, el ERP o los canales de WhatsApp, las variables de decisión cambian drásticamente. Lo que funciona bien en una prueba conceptual puede resultar costoso o lento en producción masiva.
Criterios de producción para evaluar modelos de IA corporativos
Evaluar un modelo de IA en entorno de producción exige analizar factores clave más allá de las métricas de laboratorio o mercadotecnia. Para los líderes de operaciones e infraestructura, la estabilidad de las ejecuciones es infinitamente más valiosa que las respuestas creativas.
A continuación, detallamos las cinco variables críticas que determinan la viabilidad técnica de un modelo en proyectos a medida:
- Calidad de razonamiento en lógica de negocio: Capacidad para seguir instrucciones complejas, respetar políticas internas y procesar excepciones sin alucinar.
- Fiabilidad de Function Calling: Habilidad para estructurar salidas JSON exactas que activen API en el ERP o CRM. La precisión en la ejecución de la función previene errores operacionales graves. Para profundizar en esta capacidad, revise nuestra guía sobre function calling en agentes de IA.
- Ventana de contexto y latencia: Capacidad de procesar documentos extensos o historiales de conversación manteniendo tiempos de respuesta ágiles para el usuario final.
- Costo por token a escala: Un modelo con excelente razonamiento pero costo elevado puede hacer inviable un proceso de alto volumen, como el soporte de primer nivel.
- Opciones de privacidad y despliegue: Garantías de que los datos procesados no se utilizarán para entrenar modelos públicos y flexibilidad de conexión en entornos privados.
Comparativa técnica: Claude, GPT y Gemini frente a frente
La elección entre las familias de modelos líderes debe basarse en sus fortalezas estructurales de razonamiento, costo y tamaño de contexto. Cada proveedor ha especializado sus motores hacia perfiles de uso muy definidos en la arquitectura corporativa.
| Criterio / Modelo | Claude 3.5 (Anthropic) | GPT-4o / o1 (OpenAI) | Gemini 1.5 (Google) |
|---|---|---|---|
| Fortaleza principal | Razonamiento estructurado y seguimiento estricto de directrices. | Ecosistema maduro, velocidad y visión multimodal sólida. | Ventana de contexto masiva y costo competitivo por token. |
| Function Calling | Excelente precisión en datos JSON altamente estructurados. | Muy veloz y nativo, ideal para flujos multi-paso complejos. | Efectivo, integrado nativamente con servicios de Google Cloud. |
| Ventana de Contexto | Hasta 200k tokens con altísima fidelidad de recuperación. | 128k tokens balanceados para la mayoría de sistemas. | Hasta 1M - 2M+ tokens para análisis masivo de documentos. |
| Caso de Uso Ideal | Análisis de contratos, auditoría legal, código y soporte normativo. | Agentes multimodales, atención omnicanal e integraciones rápidas. | Procesamiento de expedientes extensos y análisis de video/audio. |
Arquitectura agnóstica y enrutamiento multimodelo para reducir costos
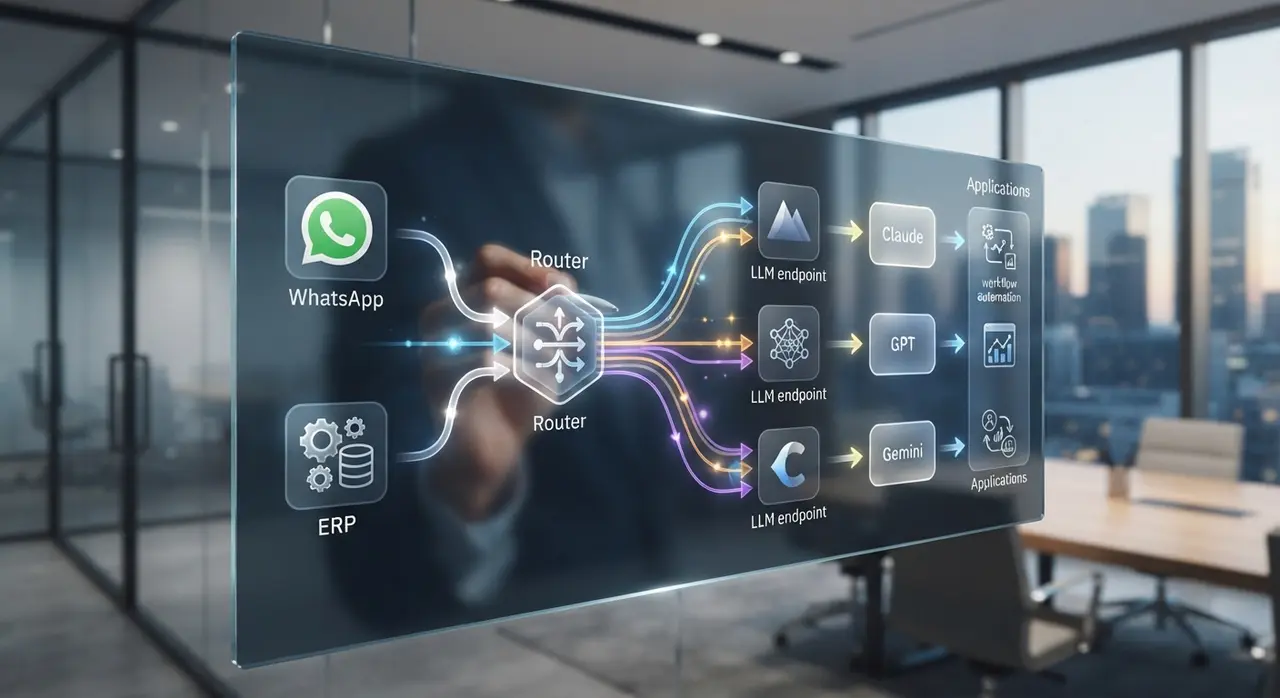
Implementar un sistema de enrutamiento multimodelo permite reducir el costo total de operación hasta en un 70% sin perder calidad de respuesta. En lugar de enviar todas las solicitudes al modelo más potente y costoso, un agente orquestador clasifica la complejidad de cada tarea en tiempo real.
Por ejemplo, en la estandarización de procesos con IA de una empresa con múltiples sedes, las consultas rutinarias de estatus de pedido pueden ser resueltas por un modelo liviano y ultra rápido como GPT-4o-mini o Gemini Flash. Por otro lado, la conciliación de una factura diferida con discrepancias de inventario se enruta hacia Claude 3.5 Sonnet.
Un caso real coordinado por Agentes Autônomos en un distribuidor logístico ilustra este beneficio: al migrar de una arquitectura de modelo único a un esquema agnóstico con enrutamiento inteligente, la empresa redujo el tiempo promedio de atención en WhatsApp de 45 segundos a 4 segundos, disminuyendo la factura mensual de tokens en un 62% mientras mantenía la tasa de resolución en el primer contacto sobre el 88%.
Soberanía de datos: API pública, nube privada y modelos Open Source
La soberanía sobre la información corporativa determina si un agente de IA debe consumirse mediante API pública, despliegue privado o alojamiento local. Dependiendo del sector —financiero, salud o industrial— la regulación condiciona el nivel de aislamiento exigido.
Las tres modalidades principales de despliegue ofrecen distintos balances entre control y esfuerzo de mantenimiento:
- API Pública Corporativa: Es la opción más rápida de implementar. Proveedores como Anthropic, OpenAI y Google ofrecen cláusulas empresariales donde garantizan que los datos transmitidos no se utilizan para reentrenamiento.
- Despliegue en Nube Privada (Azure OpenAI, AWS Bedrock, GCP Vertex): Ofrece el mismo rendimiento de los modelos comerciales pero dentro del perímetro de seguridad de la empresa, utilizando sus propias claves de cifrado e identidades de red.
- Modelos Open Source Auto-hospedados (Llama 3, DeepSeek, Mistral): Ejecutados en servidores propios o instancias GPU dedicadas. Garantizan cero salida de datos hacia terceros y costos predecibles a volumen masivo, aunque requieren mayor inversión en infraestructura y desarrollo.
La integración y la orquestación pesan más que la elección del modelo
El éxito de la automatización corporativa depende más de la calidad del flujo de trabajo y la ingeniería de contexto que del modelo subyacente. Un modelo avanzado fallará si recibe datos desordenados o carece de las herramientas adecuadas para interactuar con la operación.
Para construir una solución escalable, es indispensable centrarse en los siguientes pilares de ingeniería de software:
- Ingeniería de Prompts y Guardrails: Reglas claras de comportamiento, validadores de entrada y salida para evitar respuestas desalineadas o brechas de seguridad.
- Integración Middleware robusta: Conectores confiables entre el agente y los sistemas centralizados (SAP, Salesforce, TOTVS, Zendesk). Puede explorar ejemplos de automatización de procesos para entender cómo se estructuran estos flujos.
- Revisión Humana (Human-in-the-Loop): Diseñar puntos de verificación donde un operador revise y apruebe las acciones de alto riesgo antes de su ejecución definitiva en el ERP.
Al mantener una arquitectura neutra y agnóstica, la empresa no queda rehén de la evolución de un único proveedor. Si el mes que viene se lanza un modelo más eficiente, el sistema orquestador puede adoptarlo en horas sin rehacer las integraciones existentes.
Preguntas frecuentes
¿Qué modelo es mejor para automatizar el servicio al cliente por WhatsApp?
Para la mayoría de los casos de atención por WhatsApp, la combinación de un modelo rápido como GPT-4o-mini o Gemini Flash para la clasificación inicial junto con Claude 3.5 Sonnet para casos complejos ofrece el mejor equilibrio entre velocidad, bajo costo y precisión en las respuestas.
¿Es seguro enviar datos confidenciales de la empresa a través de las API de IA?
Sí, siempre que se utilicen planes empresariales o despliegues en nubes privadas como Azure OpenAI o AWS Bedrock. En estas modalidades, los términos contractuales garantizan legalmente que los datos del cliente no se almacenan permanentemente ni se utilizan para entrenar modelos públicos.
¿Por qué no conviene utilizar un único modelo para toda la operación?
Utilizar un único modelo genera ineficiencias financieras y operativas. Usar un modelo avanzado para tareas simples incrementa innecesariamente el costo de token, mientras que usar un modelo básico para análisis complejos aumenta la tasa de errores y alucinaciones en los procesos.
¿Cómo evita la plataforma de Agentes Autônomos la dependencia de un solo proveedor?
Agentes Autônomos utiliza una capa middleware agnóstica que separa la lógica de los procesos de negocio de la API de IA. Esto permite conectar o intercambiar modelos entre Claude, GPT, Gemini u opciones Open Source sin modificar las integraciones en su CRM o ERP.